Trong thế giới tiếp thị kỹ thuật số và tối ưu hóa công cụ tìm kiếm (SEO), việc tạo ra một bài viết chất lượng, hình ảnh bắt mắt hay thiết kế giao diện website lộng lẫy mới chỉ là một nửa chặng đường. Nửa chặng đường còn lại, mang tính quyết định sự sống còn của chiến dịch, chính là việc làm sao để cỗ máy tìm kiếm khổng lồ Google nhận diện và lưu trữ bài viết đó. Hàng ngàn nhà sáng tạo nội dung đang gặp phải chung một nỗi đau: Bài viết đã xuất bản nhiều ngày, thậm chí nhiều tuần nhưng khi tìm kiếm trên Google lại không trả về bất kỳ kết quả nào.
Vấn đề cốt lõi nằm ở quá trình Google Index (Lập chỉ mục). Nếu website của bạn không được lập chỉ mục, nó hoàn toàn không tồn tại trong mắt người dùng Internet. Bài viết chuyên sâu này sẽ “giải phẫu” toàn bộ bản chất của Google Index, cơ chế hoạt động của thuật toán, cũng như cung cấp các chiến thuật kỹ thuật thực chiến để ép Googlebot lập chỉ mục nội dung của bạn một cách thần tốc nhất.
Bản chất của Google Index
Trước khi đi tìm giải pháp ép Index, chúng ta cần phải hiểu rõ bản chất của thuật ngữ kỹ thuật này và phân biệt nó với các quy trình thu thập dữ liệu khác của công cụ tìm kiếm.
Định nghĩa về Google Index
Google Index (Lập chỉ mục) là quá trình Google đưa các trang web, bài viết, hình ảnh hoặc video của bạn vào cơ sở dữ liệu khổng lồ của họ để chuẩn bị cho việc hiển thị khi có người dùng truy vấn.
Để dễ hình dung nhất, hãy tưởng tượng Google là một thư viện lớn nhất thế giới, và bài viết trên website của bạn là một cuốn sách mới xuất bản. Quá trình Index chính là lúc người thủ thư dán mã số, phân loại cuốn sách đó thuộc thể loại gì và xếp nó lên một kệ sách cụ thể. Chỉ khi cuốn sách đã nằm ngay ngắn trên kệ (đã được Index), độc giả (người dùng Internet) mới có thể tìm thấy và mượn nó. Nếu bài viết không được Index, nó coi như “tàng hình” trên không gian mạng, dù bạn có chia sẻ liên kết đó trên mạng xã hội nhiều đến đâu thì nó cũng không bao giờ mang lại lưu lượng truy cập tự nhiên.
Phân biệt sự khác nhau giữa Crawl và Index
Rất nhiều quản trị viên website (Webmaster) thường nhầm lẫn giữa hai khái niệm Crawling (Thu thập) và Indexing (Lập chỉ mục).
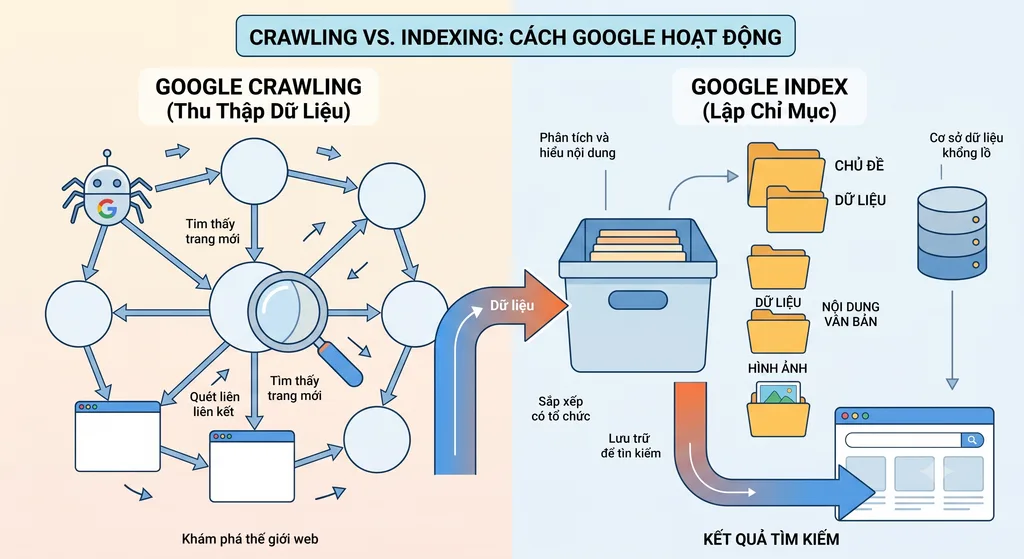
- Crawling (Thu thập dữ liệu): Là quá trình các con bọ tìm kiếm (Googlebot/Spider) đi rảo quanh mạng Internet, men theo các đường link để tìm kiếm và gom nhặt dữ liệu thô mang về máy chủ.
- Indexing (Lập chỉ mục): Là quá trình hệ thống thuật toán bắt đầu đọc, đánh giá, phân tích ngữ nghĩa và quyết định xem có nên lưu trữ dữ liệu vừa gom nhặt được vào kho cơ sở dữ liệu hay không.
Sự thật phũ phàng là: Được Crawl không đảm bảo 100% sẽ được Index. Googlebot có thể đã ghé thăm trang web của bạn, đã quét qua bài viết, nhưng nếu nó nhận thấy nội dung này quá kém chất lượng, nó sẽ quyết định ném cuốn sách đó vào thùng rác thay vì xếp lên kệ.
Giải mã cơ chế lập chỉ mục (Google Indexing)
Thuật toán Indexing của Google là một trong những hệ thống trí tuệ nhân tạo phức tạp nhất thế giới. Khi quyết định lập chỉ mục một trang, nó sẽ thực hiện một quy trình “giải phẫu” cực kỳ nghiêm ngặt.
Quy trình “giải phẫu” trang web của Googlebot
- Kết xuất (Rendering): Khác với các công cụ tìm kiếm thế hệ cũ chỉ đọc văn bản HTML thuần túy, Googlebot hiện tại sử dụng công cụ kết xuất Web Rendering Service (dựa trên nhân Chromium). Nó sẽ chạy toàn bộ các đoạn mã HTML, CSS và đặc biệt là JavaScript để “nhìn” trang web hiển thị trên màn hình giống hệt như cách một người dùng thực tế đang xem. Bước này giúp Google hiểu được giao diện, bố cục và các nội dung bị ẩn sau các nút bấm.
- Phân tích ngữ nghĩa: Sau khi kết xuất thành công, hệ thống NLP (Xử lý ngôn ngữ tự nhiên) sẽ vào cuộc. Bot tiến hành quét các thẻ Heading (H1, H2, H3), đọc nội dung thẻ Meta Title, Meta Description và thẻ Alt của hình ảnh để xác định bối cảnh, hiểu được chủ đề cốt lõi mà trang web đang đề cập đến là gì.
- Xác định độc bản: Đây là khâu kiểm duyệt khắt khe nhất. Thuật toán sẽ đối chiếu nội dung vừa đọc được với hàng nghìn tỷ dữ liệu đã có sẵn trên toàn cầu để kiểm tra xem bài viết của bạn là một tác phẩm sáng tạo mới mẻ (Unique), hay chỉ là một bản sao chép từ website khác.
Lý do bài viết bị từ chối Index (Trạng thái No Index)
Nếu bạn kiểm tra trong Google Search Console và thấy thông báo “Đã thu thập dữ liệu – hiện chưa được lập chỉ mục”, nguyên nhân thường rơi vào ba nhóm sau:
- Nội dung mỏng và hời hợt: Bài viết quá ngắn, không cung cấp đủ thông tin chuyên sâu, sao chép nội dung hoặc được tạo ra hàng loạt bằng các công cụ trộn bài. Google không muốn tốn tài nguyên máy chủ để lưu trữ những nội dung không mang lại giá trị cho người dùng.
- Bị chặn bởi rào cản kỹ thuật: Quản trị viên vô tình cấu hình sai, đặt thẻ
<meta name="robots" content="noindex">vào mã HTML của trang, hoặc dùng filerobots.txtchặn quyền truy cập của Googlebot vào thư mục chứa bài viết. - Trải nghiệm người dùng (UX) kém: Trang web mất quá nhiều thời gian để tải, giao diện vỡ nát trên thiết bị di động (Mobile-friendly lỗi), hoặc có quá nhiều quảng cáo che khuất nội dung chính.
Chiến thuật ép Index nhanh chóng
Thay vì ngồi chờ đợi Googlebot tự tìm đến một cách thụ động (có thể mất từ vài ngày đến vài tuần), bạn hoàn toàn có thể chủ động áp dụng các chiến thuật Technical SEO để “ép” hệ thống lập chỉ mục thần tốc.
Sử dụng công cụ Google Search Console
Đây là phương pháp trực diện và hiệu quả nhất. Ngay sau khi bạn xuất bản một bài viết mới, hãy copy đường dẫn (URL) của bài viết đó, đăng nhập vào Google Search Console, dán vào thanh tìm kiếm trên cùng và nhấn Enter (Tính năng Kiểm tra URL). Sau khi hệ thống kiểm tra tình trạng hiện tại, hãy nhấp vào nút “Yêu cầu lập chỉ mục”. Hành động này giống như việc bạn gửi một bức thư hỏa tốc, đặt URL của bạn lên hàng đầu trong hàng đợi thu thập dữ liệu (Crawl Queue) của Googlebot.
Điều phối luồng sức mạnh bằng Liên kết nội bộ (Internal Link)
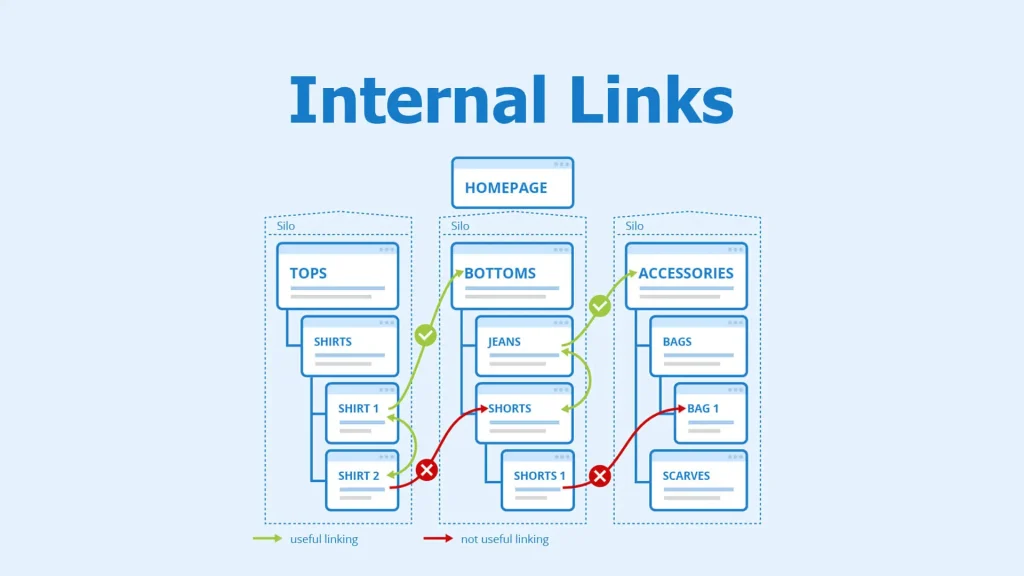
Googlebot di chuyển trên Internet thông qua các liên kết. Nếu bài viết mới của bạn không có bất kỳ đường link nào trỏ tới (Orphan Page), bọ tìm kiếm sẽ rất khó tìm thấy. Chiến thuật ở đây là: Hãy tìm những bài viết cũ trên website của bạn đã được Index ổn định, có thứ hạng cao và có lượng truy cập tốt. Chèn các đường link (Internal Link) từ những bài viết uy tín này trỏ thẳng về bài viết mới. Dòng chảy sức mạnh (Link Juice) sẽ dẫn đường cho Googlebot đi từ bài cũ sang bài mới và tiến hành thu thập dữ liệu ngay lập tức.
Tuân thủ tiêu chuẩn chất lượng nội dung
Yếu tố kỹ thuật chỉ giúp bot đến nhanh hơn, còn nội dung mới là thứ quyết định việc bot có chịu lưu trữ hay không. Để cung cấp đủ không gian cho việc phân tích ngữ cảnh từ vựng và đảm bảo chiều sâu chuyên môn, cần duy trì một tiêu chuẩn khắt khe về khối lượng văn bản. Cụ thể, bạn phải đảm bảo độ dài các gói bài viết cung cấp cho khách hàng trên blog luôn hơn 600 từ. Khối lượng nội dung chuyên sâu này tạo ra một hệ sinh thái từ khóa phong phú, chứng minh với thuật toán của Google rằng đây là một trang thông tin hữu ích, có giá trị cao và xứng đáng được ưu tiên lập chỉ mục.
Khắc phục lỗi từ chối Index
Nếu bài viết vẫn ngoan cố không chịu xuất hiện trên Google, bạn cần phải can thiệp sâu vào cấu trúc mã của trang web để gỡ bỏ các rào cản.
Kiểm tra và gỡ bỏ thẻ ngăn chặn (Noindex Tag)
Hãy mở bài viết của bạn trên trình duyệt, nhấn chuột phải và chọn “Xem nguồn trang” (View Page Source). Sử dụng tổ hợp phím Ctrl + F để tìm kiếm từ khóa “noindex”. Nếu bạn nhìn thấy dòng mã <meta name="robots" content="noindex"> xuất hiện trong phần <head>, đó chính là thủ phạm. Thẻ này ra lệnh thẳng thừng cho Google: “Không được lưu trữ trang này”. Bạn cần truy cập vào hệ thống quản trị nội dung (như cài đặt plugin Yoast SEO hoặc Rank Math trên WordPress) để cấu hình chuyển trạng thái trang thành “Index”.
Xử lý dứt điểm bằng thẻ Canonical
Trong các website thương mại điện tử, việc có nhiều đường dẫn URL khác nhau cùng trỏ về một nội dung sản phẩm là rất phổ biến (do các bộ lọc màu sắc, kích thước). Google sẽ coi đây là lỗi trùng lặp nội dung và từ chối lập chỉ mục. Để khắc phục, bạn cần sử dụng thẻ Canonical. Thẻ này giúp khai báo cho Googlebot biết đâu là phiên bản URL gốc, quan trọng nhất mà bạn muốn lập chỉ mục, từ đó hợp nhất toàn bộ sức mạnh SEO về một đường dẫn duy nhất, tránh việc phân tán ngân sách thu thập dữ liệu.
Kêu gọi hành động (CTA)
Một chiến lược Index thần tốc và một cấu trúc SEO hoàn hảo không thể được xây dựng trên một nền tảng kỹ thuật chắp vá. Để Googlebot càn quét mượt mà, 网站 của bạn cần một nền tảng chuẩn Technical SEO ngay từ cốt lõi.
Dưới sự dẫn dắt trực tiếp của System Architect Tony Do – chuyên gia sở hữu nền tảng học thuật vững chắc với bằng Cử nhân Khoa học Máy tính (Đại học Wollongong) và Thạc sĩ Khoa học (MSc) chuyên ngành Machine Learning & AI từ Đại học Liverpool John Moores (Vương quốc Anh), cùng bề dày hơn 15 năm kinh nghiệm thực chiến trong ngành phần mềm (từng đảm nhiệm vị trí Web & Mobile Lead tại tập đoàn của Singapore) – EZ Fast Tech tự hào mang đến các giải pháp kiến tạo hệ sinh thái số chuyên nghiệp và đẳng cấp nhất.
Tại EZ Fast Tech, chúng tôi định vị năng lực vô cùng sắc bén: tập trung 100% nguồn lực tinh hoa vào việc lập trình các hệ thống 网页应用和移动应用 mang lại hiệu suất cao nhất. Dù nền tảng của bạn được xây dựng trên mã nguồn mở WordPress, hay yêu cầu kiến trúc lập trình phức tạp với PHP và Laravel, mọi hệ thống đều được chúng tôi tối ưu kỹ thuật sâu sát. Kiến trúc cơ sở dữ liệu được tinh gọn giúp Googlebot càn quét mượt mà, tăng tốc độ Index lên mức tối đa.
Đặc biệt, nhằm đảm bảo quyền tự chủ tuyệt đối cho đối tác, EZ Fast Tech cam kết bàn giao 100% 源代码 minh bạch ngay sau khi dự án hoàn tất nghiệm thu, giúp doanh nghiệp hoàn toàn làm chủ tài sản số của mình và dễ dàng mở rộng trong tương lai. Liên hệ với EZ Fast Tech ngay hôm nay để loại bỏ mọi điểm nghẽn kỹ thuật và tối ưu hóa hệ thống kinh doanh trực tuyến của bạn!
Liên hệ với EZ Fast Tech ngay hôm nay để nhận giải pháp chuyển đổi số toàn diện và đưa tài sản số của bạn lên một tầm cao mới:
- 网站: https://ezfasttech.com
- 热线电话: 0768945786
- 电子邮件: [email protected]
- Facebook: https://www.facebook.com/ezfasttech
- 领英: https://www.linkedin.com/company/ez-fast-tech/
来源:
- Google Search Central: Tài liệu Hướng dẫn hoạt động của Tìm kiếm Google (Google Search Central) – Chuyên đề Crawling & Indexing
- Crawling infrastructure: Hướng dẫn quản lý ngân sách thu thập dữ liệu (Crawl Budget Management) từ Google