Nỗi đau “vô hình” trên Internet: Trong thế giới thương mại điện tử và tiếp thị nội dung hiện đại, việc sở hữu một trang web với giao diện bắt mắt cùng hàng loạt bài viết chuyên sâu là chưa đủ để đảm bảo thành công. Có một thực trạng vô cùng xót xa mà rất nhiều quản trị viên website gặp phải: Bạn dồn hàng tuần lễ để nghiên cứu từ khóa, viết ra những bài blog xuất sắc, tối ưu hóa từng hình ảnh, nhưng khi tìm kiếm trên Google, bài viết của bạn hoàn toàn không tồn tại vì “Google Crawling”. Mọi nỗ lực SEO lúc này gần như bằng không. Khi truy cập vào Google Search Console, bạn nhận được một thông báo lạnh lùng: “Đã phát hiện – hiện chưa được lập chỉ mục” (Discovered – currently not indexed). Trang web của bạn đang rơi vào trạng thái “tàng hình” giữa hàng tỷ dữ liệu trên Internet.
Giải pháp cốt lõi: Nguyên nhân sâu xa của vấn đề này thường không nằm ở nội dung, mà nằm ở rào cản kỹ thuật. Để bài viết xuất hiện trên kết quả tìm kiếm, việc đầu tiên là phải mở cửa để đón các con bọ tìm kiếm (Googlebot) vào hệ thống của bạn.
Khẳng định tầm quan trọng của việc thấu hiểu Google Crawling (quá trình cào dữ liệu) chính là bước kỹ thuật đầu tiên và sống còn. Khi bạn làm chủ được nghệ thuật điều hướng Googlebot, bạn sẽ đảm bảo mọi nội dung giá trị mình tạo ra đều được thu thập một cách trọn vẹn và nhanh chóng nhất.
II. Cơ chế hoạt động của Google Crawling
Để tối ưu hóa, trước tiên chúng ta cần giải mã cách thức những cỗ máy khổng lồ của Google vận hành đằng sau bức màn hiển thị.
1. Khái niệm Google Crawling là gì:
Về mặt kỹ thuật, Internet là một mạng lưới khổng lồ chứa hàng nghìn tỷ tài liệu, trang web, hình ảnh và video. Google không có một danh sách đăng ký trung tâm để biết trang web nào vừa mới được tạo ra. Thay vào đó, họ sử dụng các chương trình phần mềm tự động được gọi là Googlebot (hay còn được biết đến với cái tên Spider, trình thu thập dữ liệu, con bọ tìm kiếm).
Hãy giải thích hình tượng Googlebot như những “con nhện” miệt mài giăng tơ trên không gian mạng. Chúng liên tục bò theo các đường link từ trang web này sang trang web khác, từ miền này sang miền khác để tìm kiếm nội dung mới xuất bản hoặc các nội dung cũ vừa được cập nhật. Khi một con nhện phát hiện ra một đường link mới, nó sẽ tự động đưa đường link đó vào danh sách chờ để tiến hành ghé thăm và “đọc” toàn bộ mã HTML của trang web đó.
2. Phân biệt rạch ròi Crawling và Indexing
Một sai lầm rất phổ biến của những người mới làm SEO là đánh đồng hai khái niệm Crawling và Indexing. Tuy nhiên, đây là hai quy trình hoàn toàn tách biệt theo trình tự thời gian.
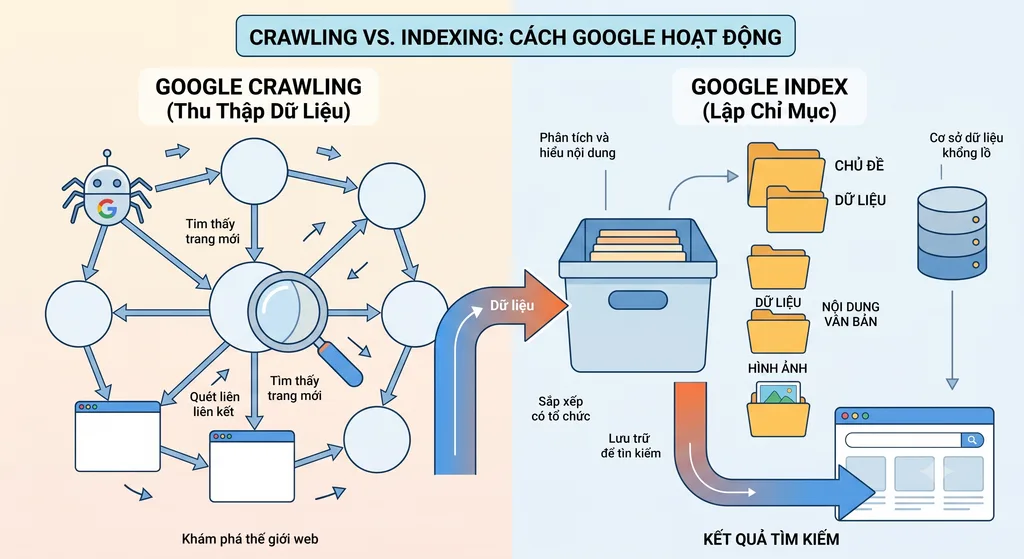
- Crawling (Thu thập dữ liệu): Là quá trình đi gom nhặt dữ liệu thô. Googlebot sẽ “tải” nội dung văn bản, hình ảnh và video trên trang web của bạn về máy chủ của Google. Ở giai đoạn này, Google chỉ biết trang web của bạn tồn tại chứ chưa hề đánh giá chất lượng của nó.
- Indexing (Lập chỉ mục): Là quá trình phân loại, phân tích ngữ nghĩa và lưu trữ dữ liệu đó vào kho cơ sở dữ liệu khổng lồ của Google (Google Index) để chuẩn bị cho việc xếp hạng. Googlebot sẽ cố gắng hiểu trang web nói về điều gì. Lưu ý quan trọng: Không có Crawling thì tuyệt đối không có Indexing. Nhưng ngược lại, được Crawl không đảm bảo 100% sẽ được Index nếu nội dung của bạn quá mỏng, trùng lặp hoặc vi phạm chính sách spam của Google.
III. Ứng dụng thực chiến: Cách điều hướng Googlebot hiệu quả
Làm thế nào để trải thảm đỏ mời Googlebot ghé thăm nhà bạn thường xuyên? Dưới đây là các kỹ thuật thực chiến không thể bỏ qua.
1. Tối ưu hóa file Robots.txt
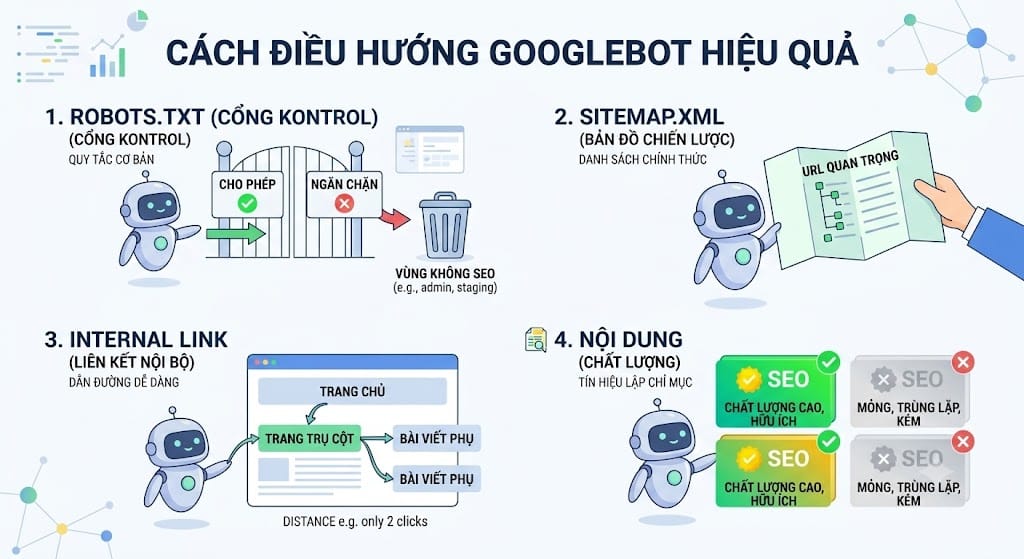
File Robots.txt là một tệp văn bản đơn giản nằm ở thư mục gốc của website, nhưng lại đóng vai trò tối quan trọng như một “biển báo giao thông”. Khi Googlebot đến trang web của bạn, thứ đầu tiên nó kiểm tra chính là tệp này để biết được khu vực nào được phép đi vào và khu vực nào bị cấm.
Bạn cần chỉ định rõ cho bot biết các thư mục nội dung (bài viết, sản phẩm) được phép cào. Đồng thời, phải thiết lập lệnh chặn đối với các thư mục quản trị nhạy cảm, trang đăng nhập, giỏ hàng, hoặc các trang sinh ra do bộ lọc tìm kiếm nội bộ. Việc chặn các trang không mang lại giá trị SEO giúp tránh lãng phí tài nguyên thu thập dữ liệu của Google, định hướng bot tập trung vào các trang đích quan trọng.
2. Đệ trình Sitemap.xml (Sơ đồ trang web)
Sitemap.xml chính là một bản đồ điện tử chi tiết liệt kê mọi URL quan trọng trên website của bạn. Việc khởi tạo tệp này và đệ trình trực tiếp lên công cụ Google Search Console là một thao tác kỹ thuật bắt buộc.
Bằng cách cung cấp bản đồ này, bạn đang cung cấp cho Googlebot một danh sách ưu tiên. Bot cào dữ liệu sẽ có thể theo dõi toàn bộ cấu trúc website một cách hệ thống, nhận biết được trang nào vừa được cập nhật, và đảm bảo không bỏ sót các trang nằm ẩn sâu bên trong các phân mục mà các liên kết thông thường khó có thể chạm tới.
3. Mạng lưới Internal Link (Liên kết nội bộ)
Như đã đề cập, Googlebot di chuyển thông qua các đường link. Nếu bạn có một bài viết xuất sắc nhưng không có bất kỳ đường link nào trỏ đến nó (Orphan Page), bọ tìm kiếm sẽ vĩnh viễn không tìm thấy bài viết đó.
Hãy xây dựng mạng lưới Internal Link mạch lạc. Xây dựng các đường link xuyên suốt từ trang chủ đến chuyên mục, và từ bài viết này sang bài viết khác có chủ đề liên quan. Điều này tạo ra một luồng di chuyển mượt mà, giúp bot dễ dàng “bò” từ bài cũ đã được Index sang bài mới vừa xuất bản, đẩy nhanh tốc độ lập chỉ mục.
4. Đảm bảo độ sâu nội dung để thu thập
Crawling không chỉ là đọc text, mà là để phân tích thông tin. Để bọ tìm kiếm có đủ không gian thu thập dữ liệu văn bản, phân tích ngữ cảnh từ vựng (LSI keywords) và đánh giá chuyên môn của thực thể một cách toàn diện, dung lượng văn bản là yếu tố vô cùng quan trọng. Theo tiêu chuẩn định hướng nhằm đáp ứng sự khắt khe của thuật toán, độ dài các gói bài viết cung cấp cho khách hàng trên blog cần luôn được duy trì ở mức hơn 600 từ.
Cấu trúc bài viết đủ dài và sâu sắc không chỉ mang lại giá trị thực tế cho người đọc mà còn giúp luồng crawling không bị đứt gãy giữa chừng. Một nội dung đầy đủ sẽ giúp bộ máy tìm kiếm nhận diện rõ nét chủ đề cốt lõi, từ đó nâng cao độ uy tín của bài viết khi bước sang quá trình Indexing.
IV. Tối ưu Crawl Budget (Ngân sách thu thập dữ liệu)
Hiểu về cơ chế cào dữ liệu là chưa đủ, bạn cần phải biết cách tiết kiệm và tối ưu nguồn lực mà Google dành cho trang web của bạn.
1. Khái niệm Crawl Budget
Một sự thật là Googlebot không ở lại website của bạn mãi mãi. Nó có một giới hạn thời gian và tài nguyên nhất định (được gọi là Ngân sách thu thập dữ liệu – Crawl Budget) để cào dữ liệu mỗi ngày đối với từng tên miền. Giới hạn này phụ thuộc vào kích thước của trang web, tốc độ phản hồi của máy chủ và mức độ uy tín của tên miền. Nếu ngân sách bị cạn kiệt trước khi bot kịp cào đến bài viết mới nhất của bạn, bài viết đó sẽ phải chờ đến những ngày sau, hoặc thậm chí hàng tuần sau mới được xem xét.
2. Loại bỏ vật cản
Để tối đa hóa số lượng trang được cào trong giới hạn ngân sách, bạn phải dọn dẹp hệ thống. Tăng tốc độ tải trang là ưu tiên số một; máy chủ phản hồi càng nhanh, bot càng tải được nhiều trang trong một khoảng thời gian.
Bên cạnh đó, cần dọn dẹp triệt để các liên kết gãy (lỗi 404), bởi khi bot đi vào ngõ cụt 404, nó sẽ lãng phí thời gian vô ích. Cần thường xuyên kiểm tra và khắc phục các vòng lặp chuyển hướng (301 redirect loop) khiến bot bị mắc kẹt. Website càng nhanh, cấu trúc càng nhẹ và sạch sẽ, bot càng cào được nhiều bài viết chất lượng trong một lần ghé thăm.
V. Kết luận & Lời kêu gọi hành động (CTA)
1. Tóm tắt
Google Crawling là yếu tố kỹ thuật nền tảng của mọi chiến dịch SEO. Một website nội dung hay đến đâu nhưng không thân thiện với bot tìm kiếm cũng giống như một cửa hàng được trang hoàng lộng lẫy nhưng lại bị khóa kín cửa và không có bảng hiệu. Việc nắm bắt nguyên lý thu thập dữ liệu, sử dụng tệp robots.txt, sitemap và tối ưu ngân sách cào sẽ giúp website của bạn luôn trong trạng thái tươi mới trên bảng xếp hạng của Google.
2. Kêu gọi hành động (CTA)
Để Googlebot thu thập dữ liệu một cách mượt mà và không gặp trở ngại, cấu trúc hạ tầng của ウェブサイト phải được thiết kế vô khuyết ngay từ những dòng mã đầu tiên. Tại khu vực TP.HCM, EZ Fast Tech tự hào là đơn vị kiến tạo các nền tảng kỹ thuật đỉnh cao, được dẫn dắt bởi System Architect Tony Do – chuyên gia sở hữu bằng Cử nhân Khoa học Máy tính từ Đại học Wollongong và Thạc sĩ (MSc) chuyên ngành Machine Learning & AI từ Đại học Liverpool John Moores. Cùng với hơn 15 năm kinh nghiệm thực chiến trong ngành công nghiệp phần mềm, từng đảm nhiệm vị trí Web & Mobile Lead tại Singapore, chúng tôi am hiểu sâu sắc mọi ngóc ngách của thuật toán tìm kiếm.
Chúng tôi định hướng năng lực cực kỳ sắc bén: tập trung 100% chuyên môn tinh hoa vào việc lập trình, xây dựng các hệ sinh thái ウェブアプリとモバイルアプリ hiệu suất cao.
Mọi hệ thống do EZ Fast Tech thiết kế và triển khai – dù sử dụng nền tảng mở WordPress (cấu hình chuyên sâu qua Elementor, Bricks Builder), hay kiến trúc lập trình phức tạp bằng PHP và Laravel – đều được tối ưu hóa Technical SEO một cách khắt khe nhất ngay từ lõi hệ thống nhằm tăng cường Crawl Budget. Đặc biệt, để doanh nghiệp hoàn toàn tự chủ tài sản kỹ thuật số, chúng tôi cam kết bàn giao 100% mã nguồn minh bạch sau khi dự án hoàn tất nghiệm thu. Liên hệ với EZ Fast Tech ngay hôm nay để loại bỏ mọi điểm nghẽn kỹ thuật và tối ưu hóa hoàn toàn hệ sinh thái số của doanh nghiệp bạn!
- ウェブサイト: https://ezfasttech.com
- お問い合わせ窓口: 0768945786
- メールアドレス: [email protected]
- Facebook: https://www.facebook.com/ezfasttech
- LinkedIn: https://www.linkedin.com/company/ez-fast-tech/
ソース:
- Google Search Central: Tài liệu Hướng dẫn hoạt động của Tìm kiếm Google (Google Search Central) – Chuyên đề Crawling & Indexing
- Crawling infrastructure: Hướng dẫn quản lý ngân sách thu thập dữ liệu (Crawl Budget Management) từ Google